Una consulta lenta no demuestra que falte un índice. Y un índice que aparece en el esquema no garantiza que PostgreSQL lo utilice. La decisión pertenece al planificador de consultas, que compara caminos de ejecución a partir de estadísticas, costes de acceso y la cantidad de filas que espera leer. Un índice puede reducir drásticamente el trabajo de una búsqueda selectiva; también puede ocupar espacio, ralentizar escrituras y ser peor opción que recorrer la tabla.
Este artículo conserva los tres mecanismos útiles del planteamiento original —B-tree, GIN e índices parciales— pero los sitúa en un modelo más completo: observar el plan, formular una hipótesis, modificar una estructura y comprobar el resultado sin tratar EXPLAIN ANALYZE como un velocímetro infalible.
La referencia técnica es PostgreSQL 18, cuya revisión menor 18.7 se publicó el 12 de noviembre de 2026. La discusión sobre skip scan corresponde a esa rama. Los ejemplos siguientes son laboratorios propuestos: no se ejecutaron ni se obtuvieron métricas durante la preparación de este artículo.
Antes del índice: qué decide el planner
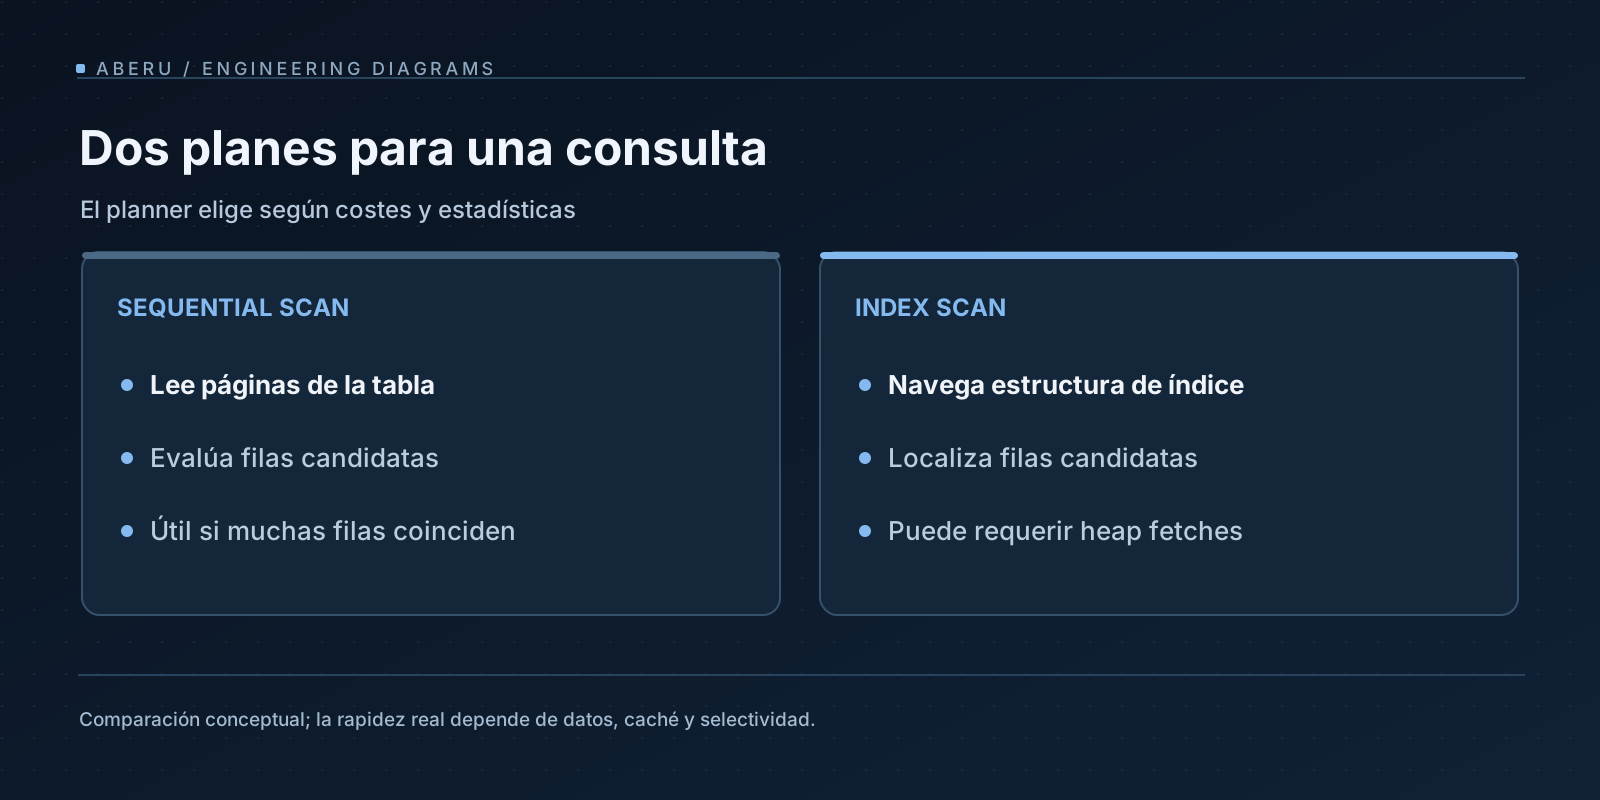
PostgreSQL necesita escoger no solo entre Seq Scan, Index Scan, Bitmap Heap Scan e Index Only Scan, sino también el orden de joins, agregaciones, ordenamientos y límites. Puede elegir un Seq Scan aunque haya un índice perfectamente válido: si la consulta va a leer buena parte de las páginas de la tabla, una lectura secuencial puede evitar accesos aleatorios al heap.
No existe un porcentaje universal de selectividad a partir del cual «convenga indexar». Influyen las páginas de la tabla, el tamaño y correlación de las columnas, los valores frecuentes, el estado de caché, el paralelismo y los parámetros de coste. Por eso un índice no debe borrarse simplemente porque una consulta o una ejecución no lo utilizó.
La guía oficial de EXPLAIN diferencia entre costes estimados y mediciones. En un plan, cost=... expresa unidades internas relativas, no milisegundos; rows=... representa cardinalidad estimada, no observada. Al añadir ANALYZE, aparecen tiempos y filas efectivas, lo que permite detectar una discrepancia entre modelo y realidad. BUFFERS completa el diagnóstico con actividad de bloques.
-- No ejecuta la consulta: muestra el plan estimado.
EXPLAIN
SELECT id, created_at
FROM orders_bench
WHERE tenant_id = 7
ORDER BY created_at DESC
LIMIT 20;

-- Sí ejecuta la consulta: úsalo sobre datos de laboratorio.
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT id, created_at
FROM orders_bench
WHERE tenant_id = 7
ORDER BY created_at DESC
LIMIT 20;
Precaución: EXPLAIN ANALYZE ejecuta también UPDATE, DELETE, INSERT y otras sentencias con efectos. No lo ejecutes sobre escrituras de producción como si solo mostrase una simulación. Si debes inspeccionar una escritura en un entorno controlado, diseña explícitamente la transacción de prueba y su recuperación.
Un laboratorio pequeño, deliberadamente sintético
Para estudiar planes necesitamos una tabla con distribuciones conocidas, no datos privados ni una supuesta captura de producción. Este esquema es autocontenido y la población mediante generate_series crea cien mil registros de ejemplo. Ajusta la cantidad a la capacidad de tu máquina; el tamaño no equivale a un benchmark representativo.
CREATE TABLE orders_bench (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tenant_id integer NOT NULL,
    customer_email text NOT NULL,
    status text NOT NULL CHECK (status IN ('open', 'paid', 'cancelled')),
    total_cents integer NOT NULL CHECK (total_cents >= 0),
    created_at timestamptz NOT NULL,
    tags text[] NOT NULL DEFAULT '{}',
    metadata jsonb NOT NULL DEFAULT '{}'::jsonb
);

INSERT INTO orders_bench (
    tenant_id, customer_email, status, total_cents,
    created_at, tags, metadata
)
SELECT
    (g % 40) + 1,
    'demo-' || (g % 1000) || '@example.invalid',
    CASE WHEN g % 20 = 0 THEN 'cancelled'
         WHEN g % 3 = 0 THEN 'open' ELSE 'paid' END,
    (g * 37) % 100000,
    TIMESTAMPTZ '2026-01-01 00:00:00+00'
        + (g * INTERVAL '1 minute'),
    CASE WHEN g % 4 = 0 THEN ARRAY['featured']::text[]
         ELSE ARRAY['regular']::text[] END,
    jsonb_build_object('channel', CASE WHEN g % 5 = 0 THEN 'web' ELSE 'store' END)
FROM generate_series(1, 100000) AS g;

ANALYZE orders_bench;
ANALYZE actualiza las estadísticas que utiliza el optimizador. Antes de añadir nada, inspecciona las consultas críticas y conserva su plan inicial para comparar. Este conjunto de datos usa reglas modulares y no reproduce distribuciones orgánicas de clientes, cancelaciones o fechas; una conclusión útil aquí necesita después validación con estadística representativa.
B-tree: igualdad, rango, orden y columnas líderes
B-tree es el método por defecto y cubre la mayoría de búsquedas convencionales por igualdad y rango, además de ayudar a evitar ciertos ordenamientos. La afirmación original «crea un índice por cada columna que filtras» es demasiado amplia: una aplicación consulta combinaciones de predicados, orden y límite. Los índices deben diseñarse para esas consultas, no para una lista aislada de atributos.
CREATE INDEX orders_tenant_created_idx
ON orders_bench (tenant_id, created_at DESC);

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, created_at
FROM orders_bench
WHERE tenant_id = 7
ORDER BY created_at DESC
LIMIT 20;
El prefijo tenant_id restringe el subconjunto y el orden descendente puede favorecer ORDER BY created_at DESC LIMIT 20. Contrasta este plan con el de una consulta sin filtro de tenant y con una que retorna miles de filas. No asumas que ambas utilizarán la misma estrategia.
Índices multicolumna y skip scan en PostgreSQL 18
El orden de las columnas importa, aunque no del modo absoluto que enseñan muchas reglas rápidas. En un B-tree (tenant_id, status, created_at), una igualdad sobre tenant_id normalmente permite delimitar mejor la búsqueda que un filtro únicamente por created_at. Sin embargo, PostgreSQL 18 documenta skip scan: cuando compensa, el motor puede generar búsquedas repetidas por posibles valores de una columna líder ausente. Su conveniencia depende, entre otras cosas, de cuántos valores distintos tenga esa columna.
CREATE INDEX orders_tenant_status_time_idx
ON orders_bench (tenant_id, status, created_at DESC);

-- Sin condición sobre la primera columna; el planner decide.
EXPLAIN
SELECT id
FROM orders_bench
WHERE status = 'open'
  AND created_at >= TIMESTAMPTZ '2026-02-01 00:00:00+00';
No es correcto afirmar que ese índice sea siempre inútil ni garantizar que aparecerá skip scan. Lo correcto es inspeccionar el plan de PostgreSQL 18 con cardinalidades y estadísticas representativas. La documentación de índices multicolumna describe ese mecanismo y sus límites.
GIN: un valor puede contener muchas claves consultables
Un GIN (Generalized Inverted Index) es útil cuando una fila aporta múltiples claves de búsqueda: términos de un tsvector, elementos de un array o rutas/valores de jsonb según la operator class. No significa que toda columna JSONB deba tener GIN ni que sea la respuesta universal para una búsqueda textual.
CREATE INDEX orders_tags_gin_idx
ON orders_bench USING gin (tags);

EXPLAIN
SELECT id FROM orders_bench
WHERE tags @> ARRAY['featured']::text[];

CREATE INDEX orders_metadata_gin_idx
ON orders_bench USING gin (metadata jsonb_path_ops);

EXPLAIN
SELECT id FROM orders_bench
WHERE metadata @> '{"channel":"web"}'::jsonb;
La elección entre jsonb_ops (por defecto) y jsonb_path_ops cambia operadores cubiertos, tamaño y comportamiento: el ejemplo usa @> de contención, admitido por jsonb_path_ops. Un índice jsonb_path_ops no sirve automáticamente para cualquier operador de existencia; selecciona la operator class a partir de las consultas reales. Para extraer y comparar una propiedad concreta también puede ser preferible un B-tree sobre una expresión, por ejemplo (metadata->>'channel').
GIN conlleva mantenimiento, espacio y amplificación de escritura; no debes activarlo «por si acaso». Los detalles están en tipos de índice de PostgreSQL y operator classes de GIN.
Índices parciales: indexar solo el subconjunto que importa
Un índice parcial contiene las filas que satisfacen un predicado. Puede ser apropiado cuando una gran parte de la tabla no aparece en la consulta crítica. Pero un índice parcial sobre active = true no ahorra gigabytes por definición: el tamaño depende de proporción, ancho, cardinalidad y tabla real.
CREATE INDEX orders_open_by_tenant_time_idx
ON orders_bench (tenant_id, created_at DESC)
WHERE status = 'open';

EXPLAIN
SELECT id, created_at
FROM orders_bench
WHERE tenant_id = 7 AND status = 'open'
ORDER BY created_at DESC LIMIT 20;
La consulta debe implicar el predicado del índice de una forma que el planificador pueda reconocer. No basta con que un humano considere dos expresiones «equivalentes»: predicados parametrizados, formas sintácticas y planes genéricos pueden afectar a esa inferencia. También hay una restricción operativa: si una fila cambia de open a paid, el índice debe actualizarse.
Consulta índices parciales antes de diseñar índices ligados a estados de negocio cambiantes.
Índices de cobertura y el límite de MVCC
INCLUDE almacena columnas adicionales sin convertirlas en claves del orden de búsqueda. Esto puede habilitar un Index Only Scan cuando el índice contiene todos los valores necesarios. Sin embargo, PostgreSQL no puede omitir siempre el heap: necesita comprobar la visibilidad MVCC de cada tupla, excepto cuando la visibility map permite confiar en que la página correspondiente está marcada como all-visible.
CREATE INDEX orders_tenant_time_cover_idx
ON orders_bench (tenant_id, created_at DESC)
INCLUDE (total_cents);

EXPLAIN (ANALYZE, BUFFERS)
SELECT created_at, total_cents
FROM orders_bench
WHERE tenant_id = 7
ORDER BY created_at DESC
LIMIT 20;
Para evaluar el beneficio, observa Heap Fetches en el plan si el optimizador selecciona un Index Only Scan. El resultado variará con actualizaciones, VACUUM y visibilidad. INCLUDE tampoco es gratuito: hace entradas hoja más voluminosas y puede perjudicar densidad, caché y mantenimiento. Referencia: Index-Only Scans and Covering Indexes.
Hash, GiST, SP-GiST y BRIN no son un catálogo de modas
PostgreSQL 18 ofrece seis métodos integrados con estructuras y operator classes diferentes:
| Método | Mecanismo principal | Patrón que puede justificarlo |
|---|---|---|
| B-tree | Claves ordenadas, búsqueda/rango | Igualdad, rango, ordenación |
| Hash | Código hash de clave | Igualdad, si la comparación operativa justifica usarlo frente a B-tree |
| GIN | Clave/elemento → filas | Arrays, full-text, JSONB según operador |
| GiST | Framework de búsqueda mediante predicados sobre estructuras | Rangos, proximidad y operadores especializados |
| SP-GiST | Particionado espacial/generalizado del espacio de búsqueda | Árboles particionados y tipos/operator classes compatibles |
| BRIN | Resúmenes por rangos de páginas físicas | Tablas grandes con fuerte correlación entre valores y ubicación |
BRIN puede ser atractivo para eventos insertados aproximadamente en orden temporal; si los timestamps llegan reordenados o los bloques mezclan valores, las lecturas adicionales pueden diluir el beneficio. No confundas la compacidad de un BRIN con capacidad de identificar una fila tan selectivamente como un B-tree.
CREATE INDEX orders_created_brin_idx
ON orders_bench USING brin (created_at);

EXPLAIN
SELECT count(*)
FROM orders_bench
WHERE created_at >= TIMESTAMPTZ '2026-03-01 00:00:00+00';
Un resultado Bitmap Heap Scan con un BRIN puede necesitar filtrar muchas filas candidatas: los resúmenes de páginas son aproximados. La referencia de BRIN explica estas características.
El coste oculto: escrituras, WAL y crecimiento
Cada índice ocupa disco, afecta caché y debe mantenerse cuando cambian columnas relevantes. Además de comparar latencia de SELECT, registra el tamaño y el uso aproximado de índices y piensa en inserciones, actualizaciones y WAL. pg_stat_user_indexes ayuda a observar escaneos; por sí solo no identifica índices prescindibles.
SELECT
    indexrelname,
    idx_scan,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE relname = 'orders_bench'
ORDER BY pg_relation_size(indexrelid) DESC;
Un índice puede respaldar una constraint o una consulta poco frecuente pero crucial. Además, estadísticas acumuladas pueden haber sido reiniciadas. Antes de eliminar algo verifica dependencias, queries y ventanas temporales relevantes.
En producción, CREATE INDEX CONCURRENTLY permite construir índices sin bloquear las escrituras normales de la misma forma que un build convencional, pero tarda más, implica varios recorridos/esperas y tiene restricciones: no puede ejecutarse dentro de un bloque de transacción y un fallo puede dejar un índice inválido que haya que investigar. No lo uses ciegamente en migraciones que envuelven todas las sentencias en una transacción.
Un protocolo de medición que evita conclusiones falsas
Para cada candidata de indexación, registra: versión menor de PostgreSQL, esquema, volumen, distribución de datos, estadísticas, configuración relevante, hardware, latencia de almacenamiento, concurrencia, caché fría/caliente, texto del SQL, parámetros, plan antes/después, tiempo medido y escrituras afectadas. Ejecuta repeticiones; separa pruebas aisladas de carga real.
Una secuencia razonable en laboratorio es:
- Crear la tabla y ejecutar
ANALYZE. - Capturar
EXPLAIN (ANALYZE, BUFFERS)de consultas de lectura representativas antes de crear el índice. - Construir una estructura candidata; registrar su tamaño.
- Repetir la consulta bajo las mismas condiciones e identificar cambios de plan, cardinalidad estimada frente a real, buffers y tiempos.
- Medir también el impacto de operaciones de escritura y el crecimiento del índice; no extrapolar solo por una SELECT.
- Repetir sobre distribuciones de datos distintas y anotar cuando el
Seq Scansea la opción correcta.
Los ocho experimentos sugeridos en el dossier del Bloque 05 —B-tree, selectividad, multicolumna/skip scan, parcial, escrituras, cardinalidad, visibilidad y BRIN— siguen pendientes de ejecución. El enlace anterior apunta a documentación primaria de EXPLAIN, no a resultados ni a un experimento ejecutado.
Cuándo la respuesta ya no es otro índice
Si la aplicación necesita OLTP relacional y sus consultas son selectivas, suele tener sentido empezar afinando modelo, estadísticas, SQL e índices. Si lo dominante son agregaciones sobre miles de millones de eventos, un layout analítico puede tener ventajas; si lo dominante es relevancia textual, autocompletado y tolerancia a errores, quizá la pregunta no sea qué B-tree añadir.
Esa decisión es distinta de la indexación dentro de PostgreSQL: en el Bloque 05 la continuamos en «Elegir una base de datos según el workload» y «Meilisearch vs Typesense». No enlazo aún esos artículos porque siguen en revisión editorial y no tienen ruta pública.
Conclusión
El objetivo no es conseguir que todos los planes muestren Index Scan. Es reducir trabajo total sin introducir un coste desproporcionado en escrituras, almacenamiento y operación. El proceso empieza mirando el plan y termina midiendo una hipótesis contra una carga real. B-tree, GIN e índices parciales siguen siendo herramientas muy valiosas; su utilidad depende de la consulta que resuelven, no de la presencia de sus nombres en una lista de buenas prácticas.
Referencias principales: PostgreSQL 18 — Indexes, Using EXPLAIN, Index-Only Scans, Release 18.7.


