
Un broker puede aceptar cientos de miles de eventos y aun así formar parte de un sistema que pierde cambios, reintenta indefinidamente o entrega información incorrecta. El throughput de un pipeline no equivale al throughput del broker: también depende de cómo se publica desde la base de origen, de qué contrato representa cada evento, de cómo se reparten las particiones, de las garantías del procesador y del comportamiento del sink.
Este artículo recorre el diseño conceptual de un pipeline PostgreSQL → outbox/CDC → Kafka o Redpanda → procesador → proyección de consulta, con un caso de órdenes de comercio electrónico. Se basa en documentación de PostgreSQL 18, Debezium, Apache Kafka 4.4, Redpanda 26.2 y Apache Flink. No es el informe de una infraestructura desplegada: los ejemplos son ilustrativos y los experimentos se proponen, pero no se han ejecutado ni medido. La selección de un sink definitivo depende del workload; ClickHouse, PostgreSQL y un sistema de búsqueda no son intercambiables solo porque reciban eventos.
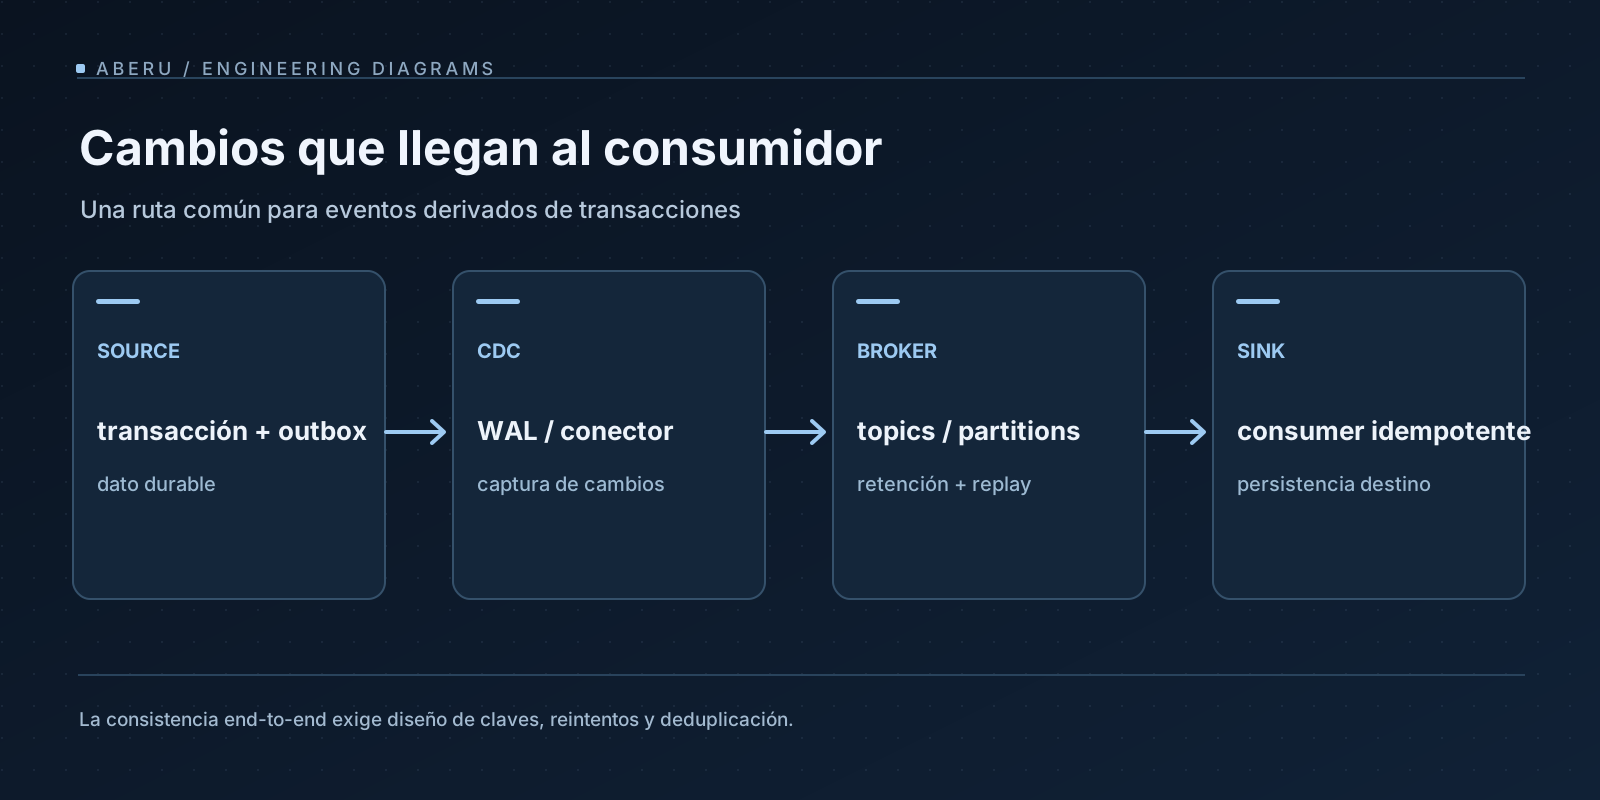
El problema real: una transacción en dos sistemas
Imaginemos una API que crea un pedido en PostgreSQL y después publica un mensaje OrderCreated.
BEGIN en PostgreSQL
  INSERT order
COMMIT en PostgreSQL
  publicar OrderCreated en el broker
El primer commit puede funcionar y la publicación fallar: la base contiene un pedido que ningún consumidor conoce. Invertir el orden tampoco resuelve el dilema: el broker podría recibir un evento cuya escritura en la base falló. Dos operaciones no atómicas realizadas sobre sistemas independientes dejan una ventana de inconsistencia.
El problema no lo arreglan un producer idempotente ni una transacción confinada al broker. La decisión arquitectónica es registrar el cambio de negocio y la intención de publicarlo en una única transacción local; después otro mecanismo entrega los eventos.
Transactional outbox: una fuente de verdad y una cola de publicación
En PostgreSQL, la transacción de aplicación puede insertar el pedido y una fila en la tabla outbox antes de confirmar. El esquema siguiente es un ejemplo pedagógico mínimo, no un esquema empresarial auditado:
CREATE TABLE orders (
  id uuid PRIMARY KEY,
  account_id uuid NOT NULL,
  status text NOT NULL,
  version bigint NOT NULL DEFAULT 1
);

CREATE TABLE outbox_events (
  id uuid PRIMARY KEY,
  aggregate_type text NOT NULL,
  aggregate_id uuid NOT NULL,
  event_type text NOT NULL,
  payload jsonb NOT NULL,
  created_at timestamptz NOT NULL DEFAULT now()
);

BEGIN;
INSERT INTO orders(id, account_id, status)
VALUES ('11111111-1111-4111-8111-111111111111',
        '22222222-2222-4222-8222-222222222222', 'created');
INSERT INTO outbox_events(id, aggregate_type, aggregate_id,
                          event_type, payload)
VALUES ('33333333-3333-4333-8333-333333333333',
        'order', '11111111-1111-4111-8111-111111111111',
        'OrderCreated',
        '{"version":1,"status":"created"}'::jsonb);
COMMIT;
Con la transacción comprometida, ambas filas existen o ninguna existe. Lo que todavía no está garantizado es que el consumidor vea el evento una sola vez. La entrega puede repetirse; la outbox resuelve la dual write inicial, no toda la semántica downstream.
La outbox necesita además una política para retención, limpieza y esquema evolutivo. Si la publicación se basa en polling, múltiples workers requieren coordinación; si se basa en CDC, el conector requiere un slot de replicación, offsets y monitoreo. No conviene confundir el contenido lógico del evento con la fila técnica que lo transporta.
CDC: leer cambios de WAL no elimina los replays
Change Data Capture mediante decodificación lógica permite derivar eventos del WAL de PostgreSQL. Debezium puede capturar cambios de una outbox y aplicar su Outbox Event Router para publicar registros con un sobre de evento adecuado. El campo aggregateid puede mapearse a la key de Kafka: así los cambios del mismo agregado siguen la estrategia de particionado elegida.
El slot lógico mantiene una posición de lectura. PostgreSQL 18 documenta que los slots son persistentes y resistentes a crashes, pero la posición puede haberse persistido solo en el último checkpoint. Después de un fallo, pueden reemitirse cambios ya procesados. La fuente de verdad sigue siendo la transacción comprometida; el consumidor debe tolerar duplicados.
El otro riesgo es operativo: un slot que no avanza retiene WAL y puede agotar almacenamiento. La arquitectura necesita alarmas sobre lag del slot, volumen de WAL retenido, estado del conector y capacidad del disco, además de un procedimiento de recuperación compatible con los datos todavía no procesados.
Fuente: PostgreSQL 18: Logical Decoding Concepts y PostgreSQL 18: Replication Slots.
El contrato del evento debe sobrevivir a un replay
Un evento no debería definirse únicamente como «el JSON que hoy devuelve la API». Requiere identidad, versión, tiempo y semántica suficientes para procesarse de forma controlada:
{
  "event_id": "33333333-3333-4333-8333-333333333333",
  "event_type": "OrderCreated",
  "event_version": 1,
  "aggregate_id": "11111111-1111-4111-8111-111111111111",
  "aggregate_version": 1,
  "occurred_at": "2026-11-17T11:00:00Z",
  "data": { "status": "created" }
}
Todos los identificadores son ficticios. event_id identifica una publicación lógica para deduplicación; aggregate_id identifica la entidad cuyo orden puede importar; aggregate_version permite detectar discontinuidades. occurred_at describe tiempo de negocio, no necesariamente el momento de procesamiento.
Una evolución de esquema debe responder preguntas prácticas: ¿pueden convivir productores y consumidores de versiones diferentes? ¿Qué campos se pueden añadir sin romper? ¿Cómo se compatibilizan replays antiguos? Schema Registry y contratos versionados ayudan a hacer explícitas estas decisiones; tener un esquema no garantiza que todos los clientes lo respeten.
Para el dominio de orden y los problemas al aumentar particiones, véase Kafka: claves de partición, orden y distribución.
Qué garantiza el broker y qué tiene que garantizar el sink
Las propiedades más citadas suelen confundirse:
| Concepto | Qué cubre | Qué no cubre automáticamente |
|---|---|---|
| Replicación | Disponibilidad/durabilidad del log bajo hipótesis de quorum | Respaldo independiente, corrección del evento |
acks=all | Confirmación bajo reglas de réplica del broker | Confirmación de la escritura en un DB externo |
| Producer idempotente | Duplicación de retries dentro del alcance de esa sesión/protocolo | Toda la cadena de side effects |
| Kafka transactions | Coordinación de escritura y offsets en workflows Kafka compatibles | Pago/API/DB arbitraria como transacción global |
| Consumer offset | Progreso de lectura registrado | Confirmación atómica con un sink externo |
| Procesador con checkpoint | Recuperación de estado interno según la semántica del motor | Que un side effect sin cooperación suceda físicamente una sola vez |
Kafka describe exactly-once para casos donde offsets y resultados pueden confirmarse transaccionalmente dentro del ecosistema Kafka. Para sinks externos se requieren acuerdos adicionales: transacción que incluya avance de progreso, idempotencia por ID de evento, actualización condicionada por versión o un sink transaccional compatible.
La frase «exactly-once end-to-end» solo tiene sentido si se especifican fronteras, efecto observable y procedimiento de recuperación. Kafka: message delivery semantics.
Ejemplo de sink idempotente en PostgreSQL
Un consumidor que actualiza una proyección puede guardar en la misma transacción la actualización y la marca de evento consumido. El ejemplo usa una proyección de pedidos con estado actual, sin pretender resolver conflictos de secuencia entre varios producers:
CREATE TABLE processed_events (
  event_id uuid PRIMARY KEY,
  processed_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE order_projection (
  order_id uuid PRIMARY KEY,
  current_status text NOT NULL,
  last_version bigint NOT NULL
);
Una transacción del sink debe intentar insertar event_id en processed_events mediante ON CONFLICT DO NOTHING, comprobar si se insertó la marca y solo si fue nueva modificar order_projection. Si la proyección falla, se revierte también la marca. Después del commit local, el consumidor puede registrar su offset. Un crash entre ambos pasos provoca replay, pero la clave única evita aplicar el mismo event_id por segunda vez.
Cuidado: esto resuelve la duplicación de un evento concreto, no corrige orden de negocio. Una nueva versión de un agregado puede llegar antes de otra y necesitar espera, reconciliación, comparación de last_version o un stream ordenado por aggregate ID. Además, las marcas de deduplicación requieren una política de retención compatible con el horizonte de replay; borrarlas demasiado pronto reintroduce duplicados.
Si el sink es un almacén analítico o un índice de búsqueda, el procedimiento debe adaptarse a sus semánticas: upsert, reemplazo por versión, colas de ingestión, eventual consistency y backfill no son lo mismo. El artículo sobre índices PostgreSQL profundiza en consultas sobre proyecciones relacionales.
Backpressure: el sistema más lento decide el ritmo
Considera una cadena conceptual:
PostgreSQL → CDC → broker → processor → sink
Si el sink solo puede consolidar una fracción de los eventos que recibe el consumer, el sistema acumula lag. Aumentar el throughput del broker no mejora el cuello de botella. Hay que medir tasas en cada tramo y diferenciar cola recuperable de pérdida o error permanente.
Un diseño operativo necesita límites: número de workers, batches máximos, memoria por proceso, timeout, política de reintento con backoff y jitter, tratamiento de mensajes inválidos y almacenamiento de DLQ. Una DLQ sin inspección ni reprocesamiento confiable no es estrategia de recuperación; simplemente desplaza el problema.
Con varias etapas en paralelo, la observabilidad debe correlacionar event_id, aggregate ID, posición/offset, latencia del source, latencia del broker y latencia del sink. Reducir promedios no prueba que se cumplan SLOs de cola p95/p99 o que la recuperación de un atraso de horas sea aceptable.
Event time, processing time y watermarks
Para streams analíticos, distinguir relojes es imprescindible. Event time describe cuándo ocurrió el hecho; processing time indica cuándo lo procesó el sistema. Los reintentos, buffers, desconexiones y relojes no sincronizados separan ambos valores.
Apache Flink usa watermarks para estimar el avance del tiempo de evento y determinar cuándo una ventana puede emitir un resultado. Una watermark no es prueba de que no llegarán eventos tardíos: un diseño debe decidir si descarta, actualiza o redirige los datos que llegan después del límite admitido.
Los checkpoints permiten reconstruir estado administrado por Flink según las garantías configuradas. La promesa exactly-once del estado interno no transfiere por arte de magia atomicidad a cada llamada HTTP externa. Para un sink compatible puede usarse un protocolo de commit coordinado; para otro, hacen falta operaciones idempotentes y reconciliación. Flink: time and watermarks y Flink: fault tolerance.
Fallos que deben formar parte del diseño
| Fallo | Señal observable | Reacción que hay que verificar |
|---|---|---|
| API confirma pedido y publicación falla | Registro en outbox sin evento consumido | CDC/poller vuelve a emitir sin duplicar efecto |
| Crash de PostgreSQL tras un checkpoint antiguo | Reemisión de cambio desde slot | Sink idempotente y progreso consistente |
| Broker pierde un líder | Retries, cambios de líder y latencias elevadas | Comportamiento de acks, producer y recuperación del grupo |
| Sink intermitente | Lag creciente, DLQ/retries | Límites de concurrencia, reintentos y drenaje |
| Cambio de esquema incompatible | Errores de deserialización | Evolución de contrato y cuarentena del evento |
| Reindexación completa | Duplicación temporal o retraso de proyección | Backfill desde snapshot + replay de cambios |
| Mensajes fuera de orden | Salto de versión del agregado | Detección, espera, conciliación o compensación |
| Migración de particiones | Cambia afinidad por aggregate ID | Corte o versionado de estrategia de particionado |
El plan de recuperación debe definir RPO, RTO, punto de reanudación, responsables, tolerancia de lag y qué controles se ejecutarán después de volver a estar «verde». Una health check positiva no demuestra por sí sola que los datos finales sean correctos.
Laboratorio y evaluación: propuesta sin resultados
El dossier propone tres familias de pruebas en torno a un dataset sintético de pedidos y cambios de estado, con identificadores reproducibles y sin datos personales:
- Publicación consistente: introducir fallos controlados entre commit, captura del outbox y entrega al broker; verificar que cada pedido comprometido llegue a ser representado.
- Semánticas: inducir duplicados, replays, rebalances, cortes de consumer y reinicios de sink; verificar exactamente qué efecto se aplica, qué se deduplica y dónde se acumula lag.
- Capacidad: cambiar tamaño de evento entre 1 KiB y 16 KiB, particiones (12/48/192), batching, distribución Zipfian/uniforme, concurrencia, compresión y límites del sink. Registrar p50/p95/p99, throughput útil, error rate, RAM, CPU y tiempo de recuperación.
La condición de éxito no debería ser «X millones de eventos por segundo». Una medida más defendible es tasa de pedidos comprometidos correctamente proyectados, con margen para replays, latencia máxima aceptable y ausencia de violación de invariantes, siempre junto con las condiciones exactas de prueba.
Hasta ejecutar los ensayos no se atribuye a Kafka, Redpanda, Debezium o Flink ninguna cifra nueva de rendimiento o fiabilidad. Debe declararse hardware, versiones, replication factor, garantía de acks, método de medición, warm-up, repeticiones, características de la base y dataset. Un benchmark publicado por un fabricante solo representa el escenario de ese fabricante.
Cuándo no construir este pipeline
Si el producto necesita búsquedas sencillas sobre un solo PostgreSQL y no existe un caso de integración asíncrona, el broker, CDC, el motor de procesamiento y un sink adicional pueden introducir más posibilidades de fallo que valor. Una cola de trabajos tradicional, una outbox con poller pequeño o incluso una consulta periódica idempotente pueden resolver mejor el problema.
Se justifica la complejidad cuando aparecen consumidores independientes, necesidad de replay, integración de múltiples servicios, eventos temporales o cargas analíticas que requieren desacoplar el OLTP. Aun así, cada componente añadido debe tener un dueño, una frontera de consistencia y una prueba de recuperación.
El principio rector es: optimizar el throughput del resultado correcto, no los mensajes que cruzan un broker. Si todavía estamos eligiendo la tecnología de mensajería, Kafka frente a Redpanda examina las diferencias del broker; si el problema es el orden por entidad, el diseño de partition keys es la pieza previa.
Fuentes y documentación primaria
- PostgreSQL 18: Logical Decoding Concepts
- PostgreSQL 18: replication slots y WAL
- Debezium: Outbox Event Router
- Apache Kafka: garantías de entrega
- Apache Kafka 4.4: documentación
- Apache Flink: event time y watermarks
- Apache Flink: checkpointing y tolerancia a fallos

