Un coding agent puede leer un repositorio, localizar archivos, editar varias piezas y ejecutar herramientas. Esa capacidad cambia la velocidad a la que se pueden proponer cambios, pero no convierte cada propuesta en una solución correcta. El punto crítico aparece cuando el agente recibe permisos para modificar el mismo entorno que el ingeniero usa para trabajar, ejecutar tests o publicar código.
La tesis aquí no es que delegar más sea mejor: la ingeniería con agentes funciona como un sistema de cambios auditables, con contexto, permisos y criterios de aceptación definidos antes de ejecutar herramientas. El resultado importante no es una respuesta convincente del modelo, sino un diff limitado que puede ser entendido, probado y aceptado o descartado.
El título hace referencia a Jcode, pero este artículo no describe como hecho un flujo personal que no se haya documentado. El dossier de investigación identifica dos herramientas independientes con ese nombre; la estrategia de trabajo que sigue es una propuesta de ingeniería aplicable a ambas, no una transcripción de una configuración privada, ni una prueba de rendimiento ejecutada.
Primero: identificar qué Jcode está ejecutando el código
La ambigüedad no es cosmética:
| Proyecto | Identidad publicada | Diferencia relevante |
|---|---|---|
| 1jehuang/jcode | jcode.sh | Harness escrito en Rust, con sesiones, providers, MCP, opciones multiagente y SDK documentados |
| cnjack/jcode | j-code.net | Agente con interfaces TUI/web/desktop y modos de aprobación/acceso descritos en su documentación |
No son versiones del mismo programa. Sus rutas de configuración, controles de permisos, modelos operativos y releases son distintos. En el momento del contraste de fuentes, el repositorio de 1jehuang/jcode publicaba v0.99.1 y cnjack/jcode publicaba v0.13.11; esos números identifican releases, no la versión que utiliza el autor de este blog.
Una experiencia personal honesta requiere confirmar el binario, origen, versión, providers, permisos, herramientas habilitadas, forma de aislar cambios y pasos reales de revisión. Hasta disponer de esa evidencia, no corresponde afirmar «mi configuración hace X», mostrar un archivo de preferencias inventado ni atribuir resultados al uso del harness.
El modelo de ejecución importa más que el prompt
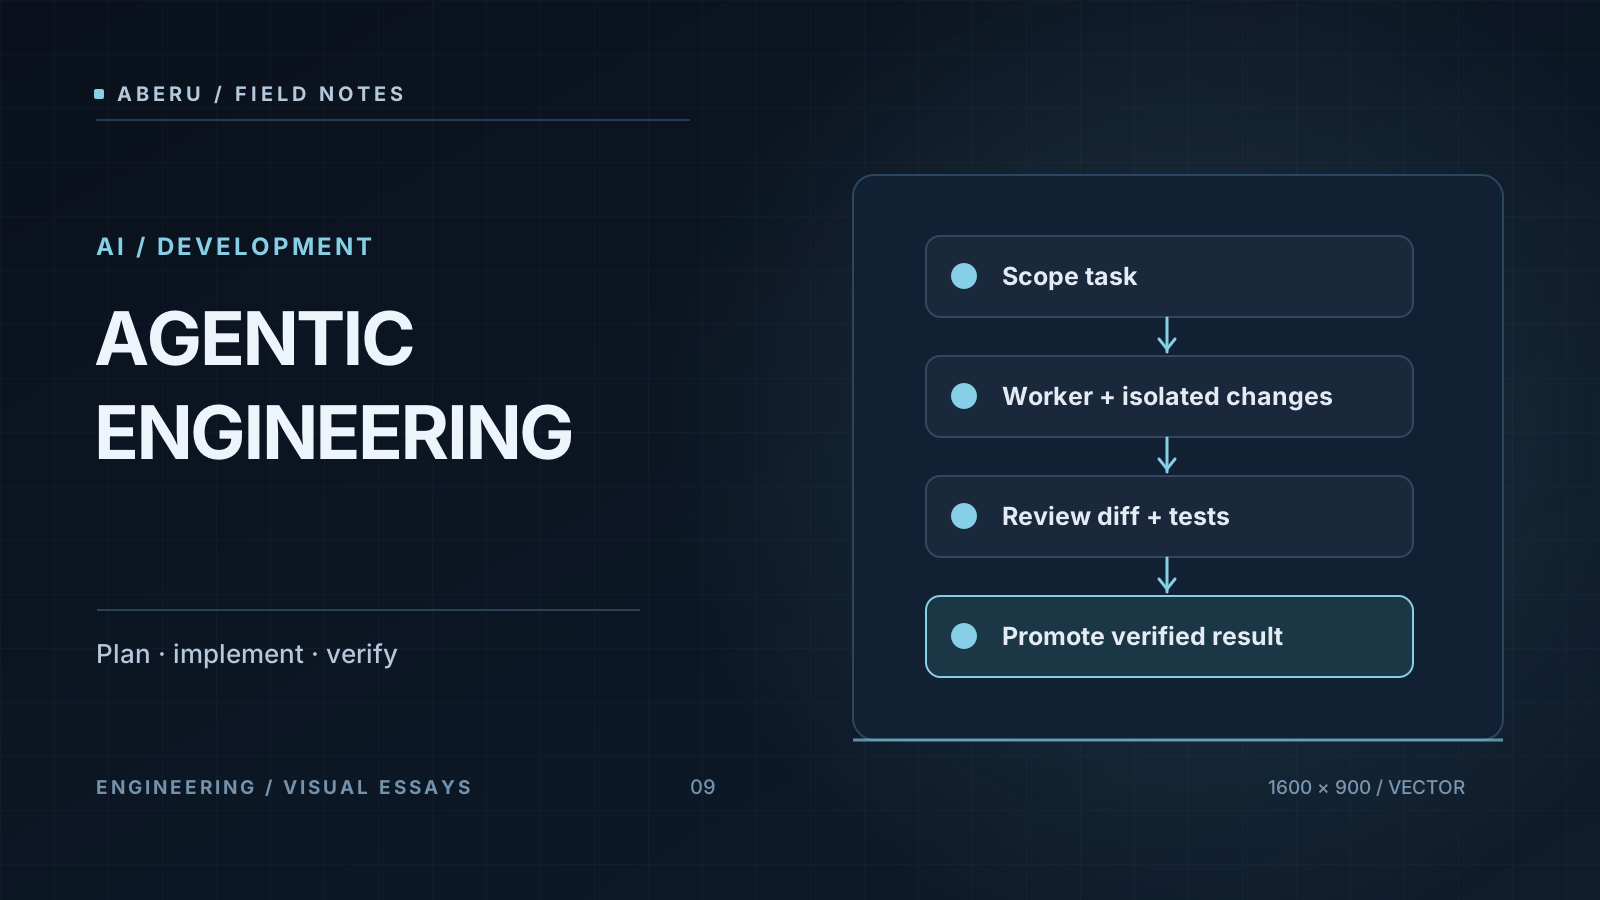
Desde ingeniería de sistemas, un agent loop combina entradas (objetivo, contexto, archivos y mensajes), un modelo que selecciona acciones y un conjunto de herramientas capaces de leer o alterar estado. Hay dos superficies diferentes que no se deben confundir: la calidad de la propuesta y la autoridad de la ejecución.
Una respuesta de texto puede sugerir un cambio incorrecto; una herramienta con acceso a shell y escritura puede materializarlo. Por eso cada paso del ciclo debería responder a una pregunta:
- Especificación. ¿Qué problema concreto debe desaparecer y cómo se comprueba?
- Contexto. ¿Qué archivos, convenciones y restricciones necesita conocer el agente?
- Plan. ¿Qué hipótesis y cambios mínimos propone, antes de escribir?
- Ejecución. ¿En qué directorio puede actuar y qué operaciones están permitidas?
- Evidencia. ¿Qué pruebas reales se ejecutaron y con qué resultado?
- Revisión. ¿Qué comportamiento verificará el ingeniero antes de integrar?
El modelo puede completar pasos internamente, pero el equipo debería conservar evidencia observable: archivos afectados, diff, comando de prueba, resultado y decisiones que requieren aprobación. La documentación de Jcode es una referencia para entender el harness 1jehuang, no un sustituto de esa trazabilidad.
Especificar una tarea que admita rechazo
«Mejora el código» no identifica una salida verificable. Considera un servicio cuya API debe devolver un error controlado cuando recibe una entrada inválida. Un encargo de ingeniería puede redactarse así:
Objetivo:
  Para una petición inválida en POST /items, devolver HTTP 400 con
  la estructura de error documentada, sin modificar casos exitosos.

Alcance:
  Revisar el endpoint, el validador y sus pruebas.
  No alterar contratos públicos distintos de este error.

Evidencia esperada:
  1) Prueba que reproduzca el fallo inicial.
  2) Cambio mínimo de implementación.
  3) Resultado real del test de regresión y del conjunto relevante.
  4) Lista de riesgos restantes.

Restricciones:
  No cambiar dependencias, variables de entorno ni infraestructura.
  No publicar cambios ni acceder a credenciales.
  Consultar antes de modificar archivos fuera del alcance.
Este texto es un ejemplo editorial, no una orden enviada a Jcode ni una prueba superada. Lo importante es que permite rechazar una solución que cambia demasiados archivos, ignora el caso negativo o no demuestra una mejora observable. Un agente también debería poder responder que necesita reproducir el problema antes de editar.
Las instrucciones específicas de proyecto, como AGENTS.md, pueden ayudar a centralizar convenciones, pero su existencia no convierte en confiable todo el contenido del repositorio. Ese matiz se vuelve crítico cuando hay issues, archivos generados, comentarios o páginas web controladas por terceros.
Separar el área de cambios del área de ejecución
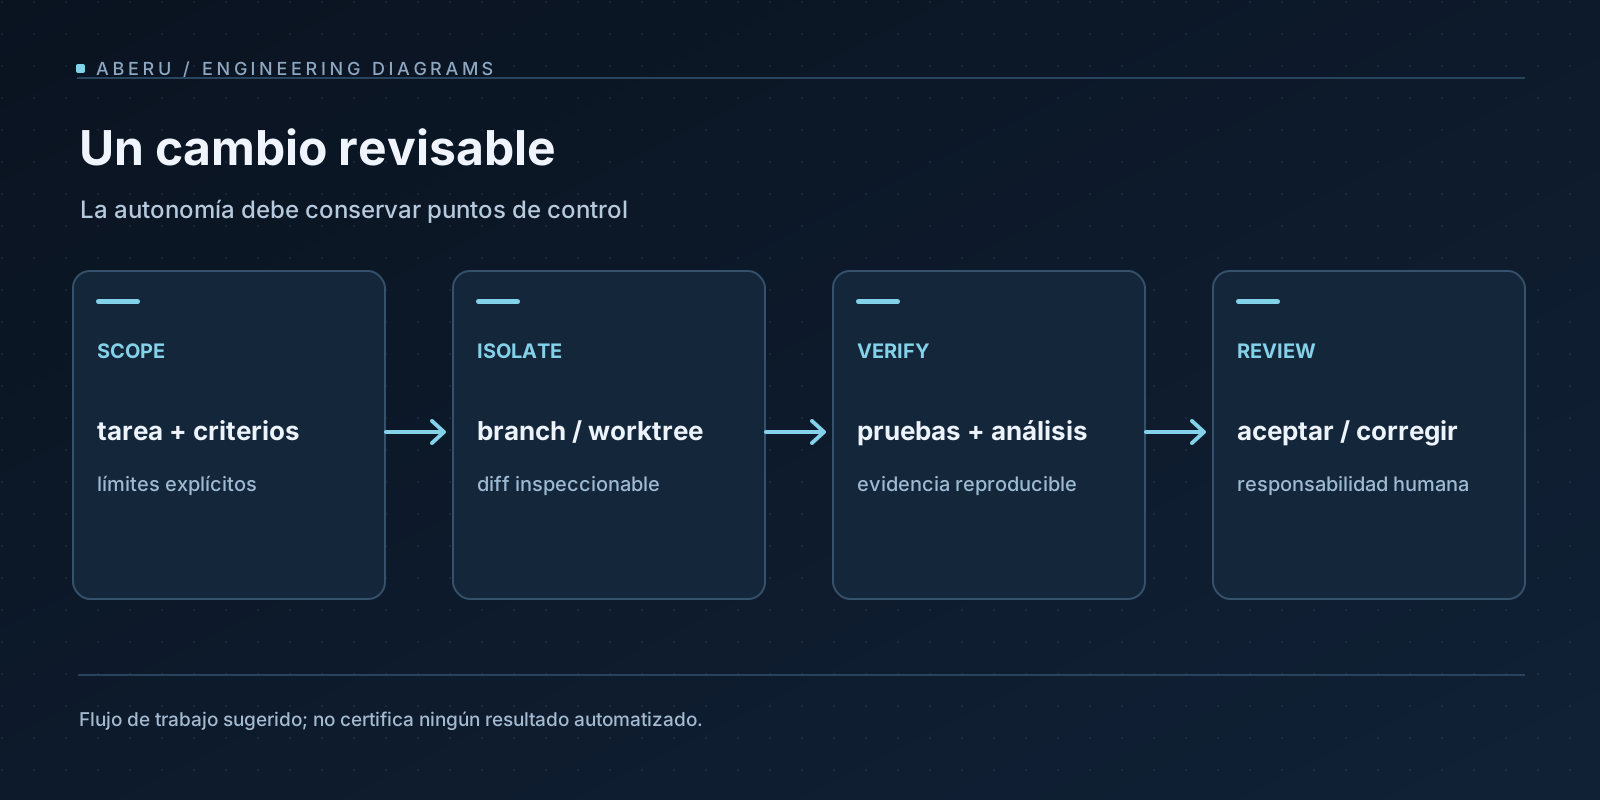
Un git worktree permite que una tarea tenga su propio directorio y rama sin interrumpir el checkout principal. No crea un sandbox, pero reduce interferencias accidentales en archivos y facilita comparar el diff.
Ejemplo para un repositorio Git existente, con la rama a crear todavía libre:
git status --short
git worktree list
git worktree add -b agent/validacion ../agent-validacion HEAD
El agente recibiría únicamente el directorio ../agent-validacion, un alcance de archivos y controles de herramientas definidos fuera del prompt. Después, desde una sesión de revisión:
git -C ../agent-validacion status --short
git -C ../agent-validacion diff --stat
git -C ../agent-validacion diff --check
git -C ../agent-validacion diff
Estos comandos inspeccionan el trabajo, no lo aceptan, ni prueban su comportamiento. Si el agente ya creó commits, también hay que inspeccionar el rango de commits con git log y un diff contra la base registrada. La documentación de worktrees explica cómo conviven directorios e índices; el artículo de este blog sobre workflows Git profundizará en esos estados cuando se publique.
La limitación de seguridad es decisiva: una worktree separa archivos de trabajo, no permisos del proceso. Si el agente puede ejecutar shell con la identidad del usuario, acceder a claves SSH, variables sensibles o conexiones de red, la separación Git no neutraliza esos permisos. El SDK de jcode.sh advierte explícitamente que su aislamiento de instancias no equivale a un sandbox de seguridad y recomienda un contenedor o una VM para ejecución no confiable.
Permisos: aprobar capacidades, no solo respuestas
La superficie de ataque aumenta a medida que el agente puede operar más allá de un directorio de código. Leer archivos, ejecutar comandos locales, conectarse a servicios y publicar cambios son capacidades de riesgo distinto. En un flujo revisable, la política tiene que imponerse desde la herramienta, el entorno o el sistema de ejecución; una frase en el prompt no puede sustituir controles de acceso efectivos.
Una progresión de privilegios podría ser:
- Lectura y diagnóstico: inspección de código y ejecución de comprobaciones permitidas, con visibilidad sobre los archivos accesibles.
- Edición controlada: cambios en una worktree delimitada, sin tocar credenciales ni configuración sensible.
- Ejecución de herramientas: comandos bajo permisos mínimos y con aislamiento adecuado cuando el código es desconocido.
- Operaciones externas: revisión explícita antes de abrir PRs, modificar CI, acceder a servicios o escribir en un remoto.
No toda herramienta admite la misma granularidad. La existencia de un «modo plan» o un diálogo de aprobación en otra variante de Jcode no demuestra que el binario usado imponga esa política. Es preciso revisar documentación y controles efectivos de la versión concreta. El trabajo de NIST sobre identidad y autoridad de agentes de software destaca que identidad, autorización y auditoría son problemas diferentes y activos.
La prompt injection entra por datos que parecen documentación
Un agente que lee repositorios y páginas externas puede encontrar texto que describe el código y texto que pretende dar instrucciones al agente. Esas categorías no deberían tener la misma autoridad. Una issue, un README ajeno, un log o una respuesta de una herramienta pueden incluir órdenes que contradicen el encargo del usuario.
OWASP describe la prompt injection indirecta como una vía para manipular el comportamiento del sistema mediante contenido externo. El peligro no exige que el archivo sea ejecutable: basta con que su contenido llegue al modelo y éste lo interprete como una instrucción privilegiada.
Una política sólida diferencia origen de la instrucción y contenido analizado. Los repositorios, resultados de búsqueda y logs proporcionan evidencia para decidir cambios; no pueden elevar por sí mismos los permisos del agente. Al detectar una solicitud sospechosa, lo útil es identificar su procedencia, omitir su carácter imperativo y continuar con la especificación autorizada.
La defensa real combina aislamiento, restricciones de herramientas, separación de secretos, revisión de comandos y supervisión humana. El texto de un prompt por sí mismo no puede garantizar que estas medidas existan.
La revisión empieza antes de que el agente diga «terminado»
Un agente puede producir tests y luego afirmar que pasan. Eso solo tiene valor si los tests se ejecutaron y sus salidas se registraron. También puede modificar el propio test para ocultar un fallo. Por eso la verificación debería examinar tanto el comportamiento como la modificación del mecanismo de evaluación.
La secuencia apropiada para un bugfix sería:
- Reproducir el problema con una prueba o escenario definido.
- Registrar un estado base y los límites de archivos permitidos.
- Aplicar el parche mínimo en el contexto aislado.
- Revisar el diff completo, incluidos cambios a tests y lockfiles.
- Ejecutar el comando real de pruebas del repositorio, no uno supuesto.
- Comprobar que el test de regresión fallaría sin el fix cuando sea viable.
- Integrar solo tras aceptación humana.
Por ejemplo, en un proyecto Astro/Bun que declare bun run test en su package.json, ese comando sería un candidato real; en un proyecto Rust no. El agente debe inspeccionar primero el script disponible. Si no puede ejecutarlo, su informe debe decir «no ejecutado», no presentar un resultado sintético. La revisión también necesita señales de calidad: errores de tipo, cambios de API, migraciones, licencias y archivos que quedaron fuera del alcance.
Tres clases de delegación y sus contratos
Refactor acotado. Mantener la API pública y los tests, limitar módulos y analizar el tamaño del diff. Aquí el riesgo es una «limpieza» que cambie comportamiento no cubierto por pruebas.
Corrección de bug. Exigir reproducción inicial, hipótesis explícita, test regresivo y verificación final. Aquí el riesgo es corregir síntomas mientras la causa permanece.
Investigación y propuesta de PR. Primero localizar fuentes, después comparar alternativas y, por último, producir cambios revisables. Aquí el riesgo es transformar suposiciones del análisis en hechos de arquitectura sin verificar.
Estos patrones no prueban que el mismo agente sea adecuado para todos los casos. La autonomía útil depende de sensibilidad del repositorio, reversibilidad, herramientas disponibles y capacidad de revisar el resultado.
¿Cómo medir si la delegación ayuda?
Un benchmark de resolución de issues mide una capacidad definida en un entorno controlado; no es una medición directa de productividad humana ni de seguridad operacional. SWE-bench Verified reúne un conjunto revisado por humanos y permite evaluar agentes en tareas de reparación, pero sus resultados dependen también del harness, los recursos y las reglas de evaluación.
La comparación con trabajo humano necesita otra metodología. En un ensayo aleatorizado de METR publicado en julio de 2025, desarrolladores open source experimentados tardaron, en promedio, aproximadamente 19% más tiempo al usar determinadas herramientas de IA de principios de 2025 en las tareas estudiadas. Ese resultado no demuestra que todos los agentes posteriores ralenticen cualquier proyecto; sí impide tomar la aceleración como un supuesto universal.
Para evaluar un workflow propio conviene registrar un conjunto acotado de tareas y mediciones comparables:
| Métrica | Qué responde | Precaución |
|---|---|---|
| Tiempo hasta PR revisable | ¿Cuánto tarda en haber una propuesta evaluable? | Incluir revisión y retrabajo, no solo generación |
| Iteraciones humanas | ¿Cuántas correcciones exige el resultado? | Depende de dificultad y definición de done |
| Pruebas fallidas / regresiones | ¿Qué defectos aparecen antes de integrar? | Diferenciar pruebas inexistentes de pruebas verdes |
| Coste y llamadas a herramientas | ¿Cuál es el coste operativo de la delegación? | Registrar modelo, versión, contexto y política |
| Tareas abandonadas | ¿Cuándo no es rentable seguir? | No ocultar casos fallidos de la muestra |
Sin un diseño de medición, hablar de «X veces más rápido» es publicidad, no ingeniería. Para el blog no se han realizado tareas comparativas, medido costes ni contado regresiones; cualquier cifra propia requerirá experimentos y evidencia que el autor pueda respaldar.
De la propuesta a la aceptación
La frontera técnica más importante no está entre escribir a mano o usar Jcode. Está entre proponer y aceptar un cambio. Un agente puede reducir fricción en exploración, creación de tests o cambios repetitivos; la responsabilidad de definir contratos, evaluar seguridad y decidir qué entra en el repositorio sigue siendo del equipo.
La siguiente iteración editorial de este artículo puede incorporar la configuración personal del autor una vez identificados el repositorio exacto de Jcode, su versión, modelo/provider, permisos, uso real de worktrees y controles de revisión. Hasta entonces, el flujo descrito es deliberadamente un patrón verificable propuesto, no un relato de primera mano.
Ese es el estándar defendible para cualquier ingeniería asistida: especificar un problema, limitar capacidades, inspeccionar el diff, ejecutar pruebas auténticas y conservar la posibilidad de rechazar el resultado. El agente es un participante en ese proceso, nunca su fuente única de verdad.
